핵심 요약
| 항목 | 내용 |
|---|---|
| RTO (Recovery Time Objective) | 장애 발생 후 서비스가 복구되기까지 허용 가능한 최대 시간 |
| RPO (Recovery Point Objective) | 장애 발생 시 손실을 허용할 수 있는 최대 데이터 양 (시간 단위) |
| 핵심 판단 기준 | RTO/RPO가 낮을수록 비용과 복잡도가 높아짐 — 비즈니스 영향도에 따라 티어를 나눠야 함 |
| 핵심 메시지 | Active/Active가 RPO 0을 보장하지 않고, Replication이 Backup을 대체하지 않으며, 목표 RTO는 DR Drill에서 검증되어야 함 |
RTO와 RPO가 왜 중요한가
장애 대응(Incident Response)은 장애가 발생했을 때 어떻게 대처하느냐의 문제입니다. 반면 장애 복구 설계(Disaster Recovery Design)는 장애가 발생하기 전에 어떻게 준비해 두느냐의 문제입니다.
장애 대응이 아무리 빨라도, 복구 설계가 없으면 복구할 수 없습니다. 백업이 없으면 데이터를 되살릴 수 없고, DR 리전이 준비되어 있지 않으면 리전 장애에서 복구할 방법이 없습니다.
RTO와 RPO는 복구 설계의 핵심 지표입니다:
- RTO (Recovery Time Objective): 장애 발생 후 서비스가 복구되기까지 허용 가능한 최대 시간
- RPO (Recovery Point Objective): 장애 발생 시 손실을 허용할 수 있는 최대 데이터 양 (시간 단위로 측정)
RTO 4시간이란 “장애 발생 후 4시간 이내에 서비스가 다시 동작해야 한다”는 의미입니다. RPO 1시간이란 “최악의 경우 1시간 치 데이터 손실을 감수할 수 있다”는 의미입니다.
HA(고가용성)와 DR(재해 복구)은 다르다
DR 설계를 시작하기 전에 HA와 DR의 차이를 명확히 이해해야 합니다. “Multi-AZ로 구성했으니 DR 되어 있는 것 아닌가?”라고 생각하기 쉽지만, 둘은 목적과 대응 범위가 다릅니다.
| 구분 | HA (High Availability) | DR (Disaster Recovery) |
|---|---|---|
| 주요 목적 | 서비스 연속성 유지 | 재해 이후 복구 |
| 대표 장애 | 인스턴스/AZ/컴포넌트 장애 | 리전 장애, 대규모 인프라 장애 |
| 대표 방식 | 중복 구성, 자동 failover | 백업, Cross-Region 복제, 복구 사이트 |
| 주요 지표 | Availability / SLA (99.9%, 99.99%) | RTO / RPO |
HA는 장애가 발생해도 서비스가 중단되지 않도록 하는 것이고, DR은 대규모 장애 후 어떻게 복구할지를 설계하는 것입니다. Multi-AZ 구성은 Zone 장애에 대한 HA를 제공하지만, Region 장애에 대한 DR은 별도로 설계해야 합니다.
RTO/RPO를 near-zero로 잡으면 안 되는 이유
RTO와 RPO가 낮을수록 좋다는 건 맞습니다. 하지만 낮추는 데는 비용이 따릅니다.
| RTO/RPO 목표 | 필요한 아키텍처 | 비용 특성 |
|---|---|---|
| RTO 24시간, RPO 24시간 | Backup & Restore | 가장 저렴, DR 인프라 상시 유지 불필요 |
| RTO 수십 분, RPO 수 분 | Pilot Light / Warm Standby | 중간, 핵심 인프라만 상시 유지 |
| RTO/RPO near-zero | Multi-Site Active/Active | 가장 비쌈, 전체 인프라 이중화 |
특정 장애 시나리오에서 RTO/RPO를 near-zero로 만들려면 여러 장애 도메인에 서비스를 동시에 배치하고, 데이터 계층에서도 해당 목표를 만족하는 복제·일관성 전략이 필요합니다. 인프라 비용이 크게 증가하며, 경우에 따라 단일 리전 대비 2배 이상의 비용이 발생할 수 있습니다.
다만 논리적 데이터 손상이나 운영자 실수까지 고려하면 Active/Active와 별도로 PITR, immutable backup 등의 복구 수단이 필요합니다. 동기 복제는 accidental DELETE나 corruption도 그대로 복제하기 때문입니다.
모든 워크로드에 동일한 RTO/RPO를 적용하면, 중요하지 않은 시스템에도 불필요한 비용을 쓰게 됩니다. 반대로 중요한 시스템에 느슨한 목표를 적용하면, 장애 시 비즈니스 손실이 커집니다.
워크로드 티어링: 모든 시스템이 같은 중요도를 갖지 않는다
RTO/RPO 설계의 첫 단계는 워크로드를 비즈니스 영향도에 따라 분류하는 것입니다.
티어 분류 예시
다음은 공식 표준이 아니라 워크로드 분류를 위한 예시입니다.
| 티어 | 설명 | Zone 장애 RTO/RPO | Region 장애 RTO/RPO |
|---|---|---|---|
| Tier 1 (Critical) | 실시간 결제, 외부 고객 서비스 | near-zero / near-zero | near-zero / near-zero |
| Tier 2 (High) | CRM, ERP, 내부 핵심 시스템 | 15분 / 15분 | 1시간 / 1시간 |
| Tier 3 (Medium) | 백오피스, HR, 회계 시스템 | 1시간 / 1시간 | 12시간 / 12시간 |
| Tier 4 (Low) | 개발 환경, 테스트 서버 | 24시간 / 24시간 | 복구 필요 시 재구축 |
위 티어는 GCP의 DR 설계 예시와 일반적인 엔터프라이즈 BIA(Business Impact Analysis) 모델을 참고해 확장한 예시입니다. AWS 역시 워크로드별 비즈니스 영향도와 기술적 요구사항을 기준으로 RTO/RPO를 개별 정의할 것을 권장합니다. 실제 티어와 수치는 조직의 BIA 결과에 따라 결정해야 합니다.
티어 분류 시 고려할 질문
- 이 워크로드가 1시간 동안 중단되면 얼마의 매출 손실이 발생하는가?
- 데이터 1시간 치를 잃으면 재생성할 수 있는가? 규제 위반이 발생하는가?
- 이 워크로드에 의존하는 다른 시스템은 무엇인가?
- 연말 정산, 블랙프라이데이처럼 특정 시기에 RTO/RPO 요구사항이 달라지는가?
AWS의 4가지 DR 전략
AWS Well-Architected Framework는 비용과 복잡도에 따라 4가지 DR 전략을 정의합니다.
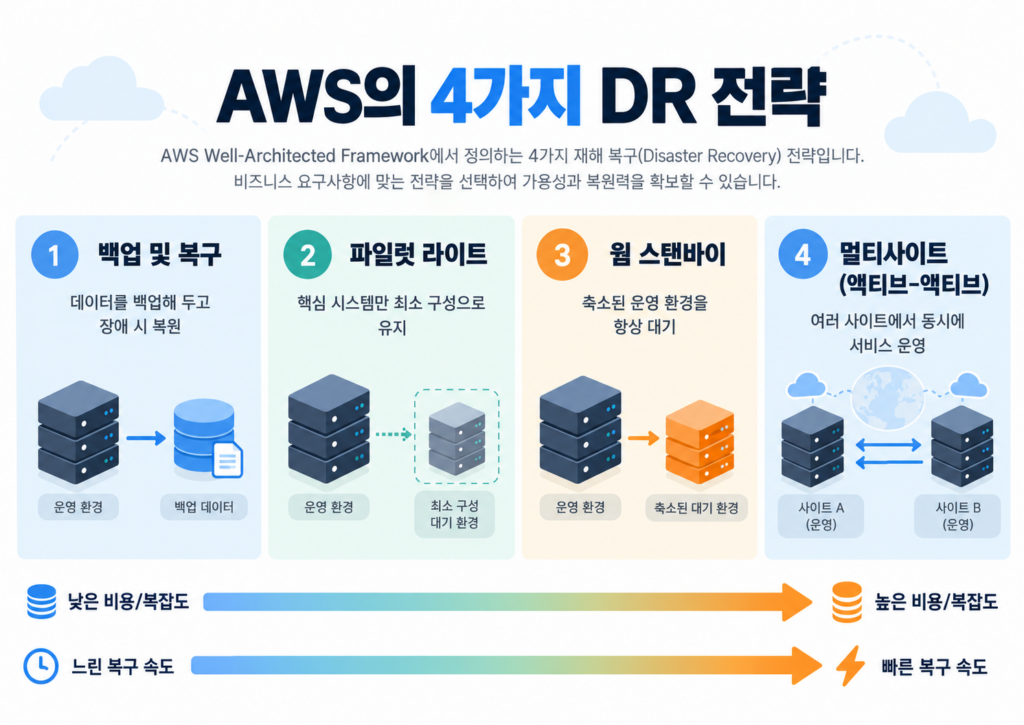
1. Backup & Restore
특성: 일반적인 RPO 수 시간, RTO 수 시간 ~ 24시간
데이터를 주기적으로 백업하고, 장애 발생 시 DR 리전에서 인프라를 재배포합니다.
- 장점: 가장 저렴, DR 리전에 상시 운영 인프라 불필요
- 단점: RTO가 길고, 복구 과정이 복잡할 수 있음
- 적합한 경우: Tier 3, Tier 4 워크로드
평상시: Primary Region에서만 운영
        Primary → DR로 백업 복제

장애 시: DR Region에서 인프라 재배포 (IaC 사용)
        백업에서 데이터 복원
2. Pilot Light
특성: 일반적인 RPO 수십 분, RTO 수십 분
핵심 인프라(데이터베이스 등)만 DR 리전에서 항상 실행합니다. 애플리케이션 서버는 장애 시 시작합니다.
- 장점: Backup & Restore보다 빠른 복구
- 단점: 핵심 인프라 비용은 상시 발생, 추가 작업 없이는 요청을 처리할 수 없음
- 적합한 경우: Tier 2 워크로드
평상시: Primary Region 전체 운영
        DR Region에 데이터베이스만 복제 상태로 유지
        애플리케이션 서버는 AMI/이미지만 준비

장애 시: DR Region에서 애플리케이션 서버 시작
        트래픽 전환
3. Warm Standby
특성: 일반적인 RPO 수 분, RTO 수 분
DR 리전에서 축소된 규모의 전체 시스템을 항상 실행합니다. 장애 시 스케일 아웃만 하면 됩니다.
- 장점: 빠른 복구, 테스트 용이, 이미 동작 중이며 제한된 규모라도 요청을 처리할 수 있음
- 단점: DR 리전 인프라 비용이 상시 발생 (축소 규모)
- 적합한 경우: Tier 1~2 워크로드
평상시: Primary Region 전체 운영
        DR Region에서 축소된 규모의 전체 시스템 운영
        필요하면 제한된 트래픽을 처리할 수 있는 상태

장애 시: DR Region 용량 확대
        전체 트래픽 전환
Pilot Light와 Warm Standby의 핵심 차이: Pilot Light는 추가 작업 없이는 요청을 처리할 수 없지만, Warm Standby는 이미 동작 중이며 제한된 규모라도 요청을 처리할 수 있습니다.
4. Multi-Site Active/Active
특성: 일반적인 RTO near-zero, RPO near-zero
두 개 이상의 리전에서 동시에 트래픽을 처리합니다.
- 장점: 가장 빠른 복구 (사실상 failover 개념이 없음)
- 단점: 비용이 매우 높음, 아키텍처 복잡도 높음, 데이터 일관성 설계 필요
- 적합한 경우: Tier 1 워크로드 중에서도 미션 크리티컬 시스템
평상시: 두 Region 모두에서 트래픽 처리
        데이터 동기식 복제 또는 conflict resolution 필요

장애 시: 장애 Region으로의 트래픽만 차단
        정상 Region이 전체 트래픽 처리
주의: Multi-Site Active/Active는 RTO를 near-zero 수준까지 낮출 수 있지만, RPO는 데이터 계층의 복제 및 일관성 모델에 따라 달라집니다. Active/Active 자체가 RPO 0을 의미하지는 않습니다. 애플리케이션 계층은 Active/Active인데 데이터 계층이 비동기 복제일 수도 있습니다.
전략별 비용과 복잡도 비교
| 전략 | 상시 DR 인프라 비용 | 일반적인 RTO | 일반적인 RPO | 복잡도 |
|---|---|---|---|---|
| Backup & Restore | 스토리지 비용만 | 수 시간 ~ 24시간 | 수 시간 | 낮음 |
| Pilot Light | 핵심 인프라 비용 | 수십 분 | 수십 분 | 중간 |
| Warm Standby | 축소 인프라 비용 | 수 분 | 수 분 | 중간~높음 |
| Multi-Site Active/Active | 매우 높음 | near-zero | near-zero | 높음 |
위 값은 전략의 전형적인 범위를 설명하기 위한 예시이며, 실제 RTO/RPO는 사용 서비스, 자동화 수준, 데이터 복제 방식 및 failover 절차에 따라 달라집니다.
데이터 보호 방식과 RPO의 관계
RPO를 낮추려면 데이터 복제 빈도를 높여야 합니다.
| 데이터 보호 방식 | 일반적인 RPO 특성 |
|---|---|
| 일 1회 snapshot/backup | 최대 약 24시간 |
| 주기적 snapshot | snapshot 주기에 좌우 |
| Continuous backup / PITR | 서비스의 restore granularity와 로그 보존 정책에 좌우 |
| 비동기 cross-region replication | replication lag에 좌우 (수 초 ~ 수 분) |
| 동기/quorum 복제 | 특정 장애에 대해 near-zero 가능 |
동기 vs 비동기 복제
동기 또는 quorum 기반 복제:
- 쓰기 성공 전에 여러 장애 도메인에 데이터가 안전하게 기록되도록 보장합니다.
- 매우 낮은 RPO를 달성할 수 있지만, 복제 거리와 quorum 구성에 따라 write latency가 증가할 수 있습니다.
- 정상적으로 quorum에 commit된 데이터에 대해서는 복제본 손실로 인한 데이터 유실 가능성을 매우 낮출 수 있습니다.
- 예: Google Cloud Spanner multi-region, 일부 strongly consistent distributed database 구성
비동기 복제 (Asynchronous):
- 쓰기 작업이 Primary에 커밋되면 즉시 성공 응답을 반환합니다.
- 복제 지연(Replication Lag)만큼 데이터 손실 가능성이 있습니다.
- 예: AWS Aurora Global Database, Azure SQL Database Active Geo-Replication, GCP Cloud SQL cross-region replica
중요: 동기 복제도 logical corruption, accidental DELETE, application bug, ransomware에는 도움이 되지 않을 수 있습니다. 오히려 잘못된 write가 모든 replica에 즉시 전파됩니다. Replication은 Backup을 대체하지 않습니다.
분산 데이터베이스의 복제 특성
분산 데이터베이스 서비스(예: Azure Cosmos DB)는 구성과 consistency level에 따라 replication semantics가 달라질 수 있으므로 제품 단위가 아니라 실제 consistency/replication 설정을 기준으로 RPO를 평가해야 합니다.
Zone 장애 vs Region 장애
DR 설계 시 어떤 범위의 장애에 대비할지 결정해야 합니다.
Zone 장애
- 단일 데이터센터 또는 가용 영역 장애
- 리전 내 다른 Zone에서 복구 가능
- 대부분의 Regional 서비스는 자동으로 Zone 장애를 견딤
대응 방법:
- 멀티 AZ 배포 (AWS)
- 가용성 영역 분산 (Azure)
- Regional 리소스 사용 (GCP)
Region 장애
- 전체 리전 장애 (자연재해, 대규모 인프라 장애)
- 다른 리전에서 복구해야 함
- 훨씬 드물지만, 발생 시 영향 범위가 큼
대응 방법:
- Cross-Region 복제
- Multi-Region 아키텍처
- DR 리전 사전 준비
장애 범위에 따른 서비스 선택
| 장애 범위 | AWS 예시 | Azure 예시 | GCP 예시 |
|---|---|---|---|
| Zone 장애 대응 | Multi-AZ RDS, Regional EBS | Zone-redundant Storage, SQL Database Zone Redundancy | Regional Persistent Disk, Regional GKE |
| Region 장애 대응 | Aurora Global DB, S3 Cross-Region Replication | Geo-Redundant Storage, SQL Database Active Geo-Replication | Spanner Multi-Region, Cloud Storage Dual-Region |
실제 RTO에 영향을 주는 요소
목표 RTO(Target RTO)와 실제 달성 RTO(Achieved RTO)는 다릅니다. 문서에 적힌 RTO는 목표일 뿐입니다. 실제 DR Drill에서 측정한 복구 시간이 목표 이하인지 검증해야 합니다.
Target RTO:   60분
Drill #1:     83분 ❌
Drill #2:     58분 ✅
Drill #3:     44분 ✅
종속성과 Critical Path
A 시스템의 RTO가 1시간이라도, A가 의존하는 B 시스템의 RTO가 4시간이면, 실제 A의 RTO는 4시간입니다.
Customer API
   │
   ├── Auth       RTO 15m
   ├── Database   RTO 30m
   └── Payment    RTO 2h
                   ↑
              Critical Path

Effective RTO ≈ 2h
실무 DR 설계는 개별 component RTO가 아니라 service dependency graph를 보는 문제입니다.
DNS TTL과 Traffic Failover
RTO는 단순히 “서버가 켜지는 시간”이 아니라 “서비스가 사용자에게 정상 제공될 때까지의 end-to-end 시간”입니다.
Infrastructure recovery: 4분
Database promotion:       2분
Health validation:        3분
DNS propagation:          5분
────────────────────────────
Actual RTO:              14분
DNS TTL 설정이 길면 인프라가 복구되어도 사용자 트래픽이 전환되기까지 추가 시간이 걸립니다.
Control Plane 의존성
DR Region에 IaC가 있으니 복구 가능하다고 생각하기 쉽지만, 리전 장애 직후 수백 개의 리소스를 새로 생성해야 하는 구조는 control plane availability와 quota에 의존합니다. 낮은 RTO가 필요할수록 “복구 시 생성”보다 “이미 실행 중인 capacity”가 유리합니다.
AWS는 failover에서 가능한 경우 data plane operation을 사용하라고 권장하며, GCP 역시 business-critical recovery가 VM creation API나 IAM update 같은 management plane operation에 의존하지 않는 것이 중요하다고 설명합니다.
RTO/RPO 설정 시 흔한 실수
1. 모든 워크로드에 동일한 목표 적용
“모든 시스템 RTO 1시간”이라고 정하면, 개발 서버에도 불필요한 DR 인프라 비용이 발생합니다. 반드시 티어링이 필요합니다.
2. 복구 테스트 없이 목표만 설정
RTO 4시간을 목표로 설정했지만, 실제로 복구 테스트를 해본 적이 없다면 그 목표는 의미가 없습니다. 정기적인 DR 훈련(Drill)이 필수입니다.
3. 종속성 고려 누락
A 시스템의 RTO가 1시간이라도, A가 의존하는 B 시스템의 RTO가 4시간이면, 실제 A의 RTO는 4시간입니다. 종속성 체인 전체를 고려해야 합니다.
4. 비용 분석 없이 목표 설정
비즈니스 부서에서 “RTO 0″을 요구하면, 아키텍트는 비용을 산출해서 제시해야 합니다. 1시간 다운타임 비용과 Multi-Site Active/Active 유지 비용을 비교하면, 현실적인 목표가 도출됩니다.
5. 데이터 복구만 고려하고 애플리케이션 복구 누락
백업에서 데이터베이스를 복원해도, 애플리케이션 서버, 설정, 네트워크가 준비되지 않으면 서비스가 복구되지 않습니다. IaC(Infrastructure as Code)로 전체 스택을 재배포할 수 있어야 합니다.
6. Replication이 Backup을 대체한다고 생각
동기 복제나 Active/Active 구성이 있어도 논리적 데이터 손상, 실수로 인한 삭제, 랜섬웨어 공격에는 별도의 백업이 필요합니다.
7. Failback 계획 누락
DR Region으로 전환한 후, 원래 Primary Region으로 돌아가는 Failback 절차도 설계해야 합니다. Failover보다 Failback이 더 복잡한 경우가 많습니다. DR 기간 동안 DR Region에 쌓인 데이터를 다시 Primary로 동기화해야 하고, 전환 시점에 데이터 일관성을 검증해야 합니다. Failback 계획이 없다면 DR Region을 장기간 새로운 Primary로 운영하게 될 수 있으며, 이 경우 복제 방향, 용량 계획, 운영 비용까지 다시 설계해야 할 수 있습니다.
RTO/RPO 결정을 위한 체크리스트
티어별로 다음 질문에 답하면 현실적인 RTO/RPO를 도출할 수 있습니다:
- [ ] 이 워크로드의 1시간 다운타임 비용은 얼마인가?
- [ ] 1시간 치 데이터 손실의 비즈니스 영향은 무엇인가?
- [ ] 규제나 계약에서 요구하는 RTO/RPO가 있는가?
- [ ] 이 워크로드에 의존하는 상위 시스템의 RTO/RPO는 무엇인가?
- [ ] DR 인프라에 월/연간 얼마를 투자할 수 있는가?
- [ ] 복구 절차를 정기적으로 테스트할 인력과 프로세스가 있는가?
- [ ] DR Region의 quota와 capacity가 전체 production traffic을 수용할 수 있는가?
- [ ] DNS TTL 설정이 목표 RTO에 적합한가?
정리
DR 전략 = Business Impact × Failure Scope × RTO/RPO × Cost
먼저 DR 제품을 고르는 것이 아니라, 장애 범위와 비즈니스 손실을 정의한 다음 RTO/RPO를 결정하고 마지막에 아키텍처를 선택해야 합니다.
- 모든 워크로드에 동일한 목표를 적용하지 마세요. 티어링이 필수입니다.
- 비용과 복잡도를 고려하세요. RTO/RPO near-zero는 비용이 크게 증가합니다.
- Zone 장애와 Region 장애를 구분하세요. 대부분의 워크로드는 Zone 장애 대응만으로 충분합니다.
- 정기적으로 테스트하세요. 테스트하지 않은 DR 계획은 계획이 아닙니다.
- Replication ≠ Backup. 동기 복제도 논리적 손상에는 무력합니다.